

M-Learning: Heuristic Approach for Delayed Rewards in Reinforcement Learning
Se presenta el trabajo de grado de pregrado desarrollado por Marlon Sneider Mora Cortes, Cesar Andrey Perdomo Charry y Oscar J. Perdomo ha sido reconocido con la distinción de Tesis Laureada. La investigación fue publicada este 2025 en la revista internacional Mathematics (MDPI), haciendo parte de la sección Computer Science en la edición especial Metaheuristic Algorithms, 2nd Edition.
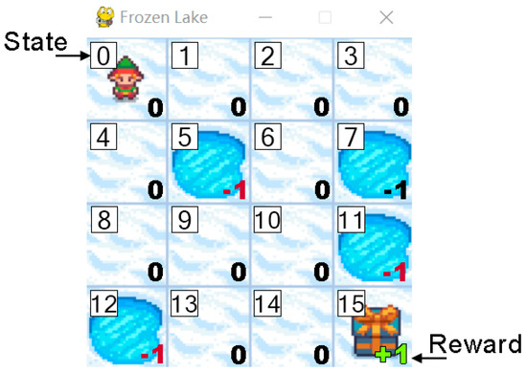
Los métodos tradicionales de Aprendizaje por Refuerzo (Reinforcement Learning, RL) y de Aprendizaje Profundo por Refuerzo (como Deep Q-Networks o DQN) suelen requerir miles o millones de episodios de entrenamiento para converger, lo que implica una alta demanda de recursos computacionales. Este problema se agrava drásticamente en entornos con recompensas tardías o dispersas (delayed rewards), donde el agente solo recibe retroalimentación al alcanzar el objetivo final o al fallar, navegando a ciegas durante la mayor parte de su trayectoria.
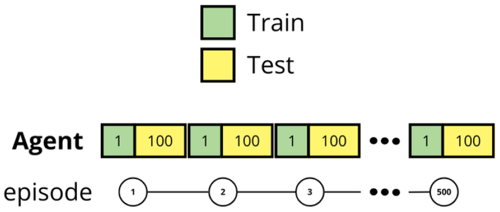
Descripción general de la metodología utilizada para entrenar y evaluar los métodos.
Este proyecto introduce M-Learning, un nuevo algoritmo heurístico diseñado para optimizar el aprendizaje en Procesos de Decisión de Markov (MDP) con recompensas diferidas. A diferencia de esquemas clásicos como Q-Learning, que buscan convergencia óptima mediante tablas de valores $Q(s, a)$ y políticas de exploración $\epsilon$-greedy dependientes de múltiples hiperparámetros ($\alpha, \gamma, \epsilon$), M-Learning estructura la toma de decisiones modelando directamente distribuciones de probabilidad sobre las acciones en una tabla de memoria.
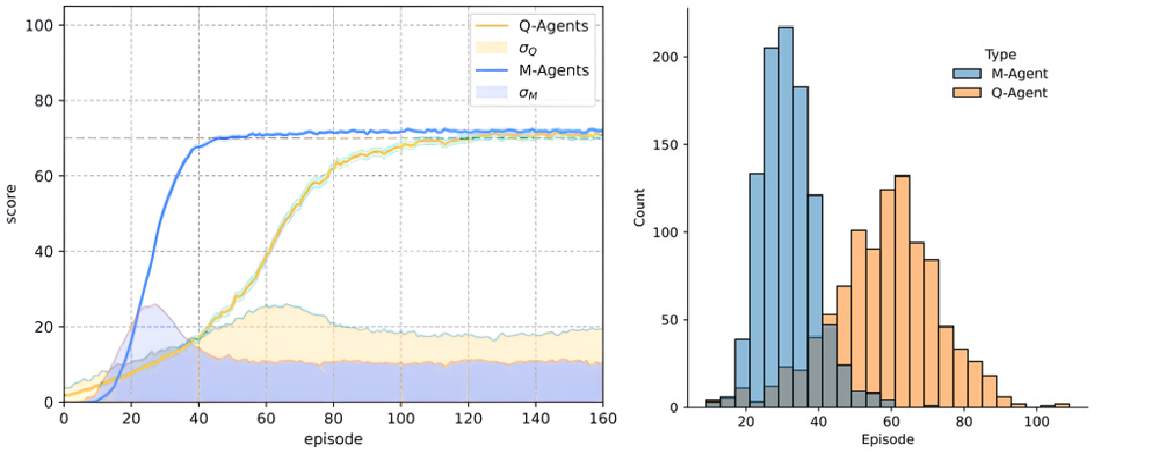
Resultados obtenidos con los algoritmos Q-Learning y M-Learning en el entorno estocástico.
- Mayor velocidad de convergencia: En pruebas controladas bajo el entorno de referencia Frozen Lake (Gymnasium):
- Entorno determinista: M-Learning logró la tasa de éxito total en solo 18 episodios, frente a los 24–26 requeridos por el mejor ajuste de Q-Learning.
- Entorno estocástico: Alcanzó el umbral de éxito superior al 70% en solo 46 episodios, mientras que Q-Learning necesitó entre 101 y 120 episodios.
- Menor dispersión y estabilidad: M-Learning mostró una variabilidad notablemente reducida entre corridas experimentales repetidas (evaluadas con cohortes de hasta 1.000 agentes), eliminando la dependencia crítica del ajuste fino de hiperparámetros de exploración.
💻Acceso a la documentación completa:
- Artículo completo (Acceso Abierto / Open Access): MDPI Mathematics — Art. 2108
- Identificador DOI: 10.3390/math13132108
- Descarga directa en PDF: Disponible libremente en el portal de MDPI bajo licencia Creative Commons Attribution (CC BY 4.0).
Como citar este articulo👆:
@article{perdomo2025mlearning,
title = {M-Learning: Heuristic Approach for Delayed Rewards in Reinforcement Learning},
author = {Perdomo Charry, Cesar Andrey and Mora Cortes, Marlon Sneider and Perdomo, Oscar J.},
journal = {Mathematics},
volume = {13},
number = {13},
pages = {2108},
year = {2025},
publisher = {MDPI},
doi = {10.3390/math13132108}
}


